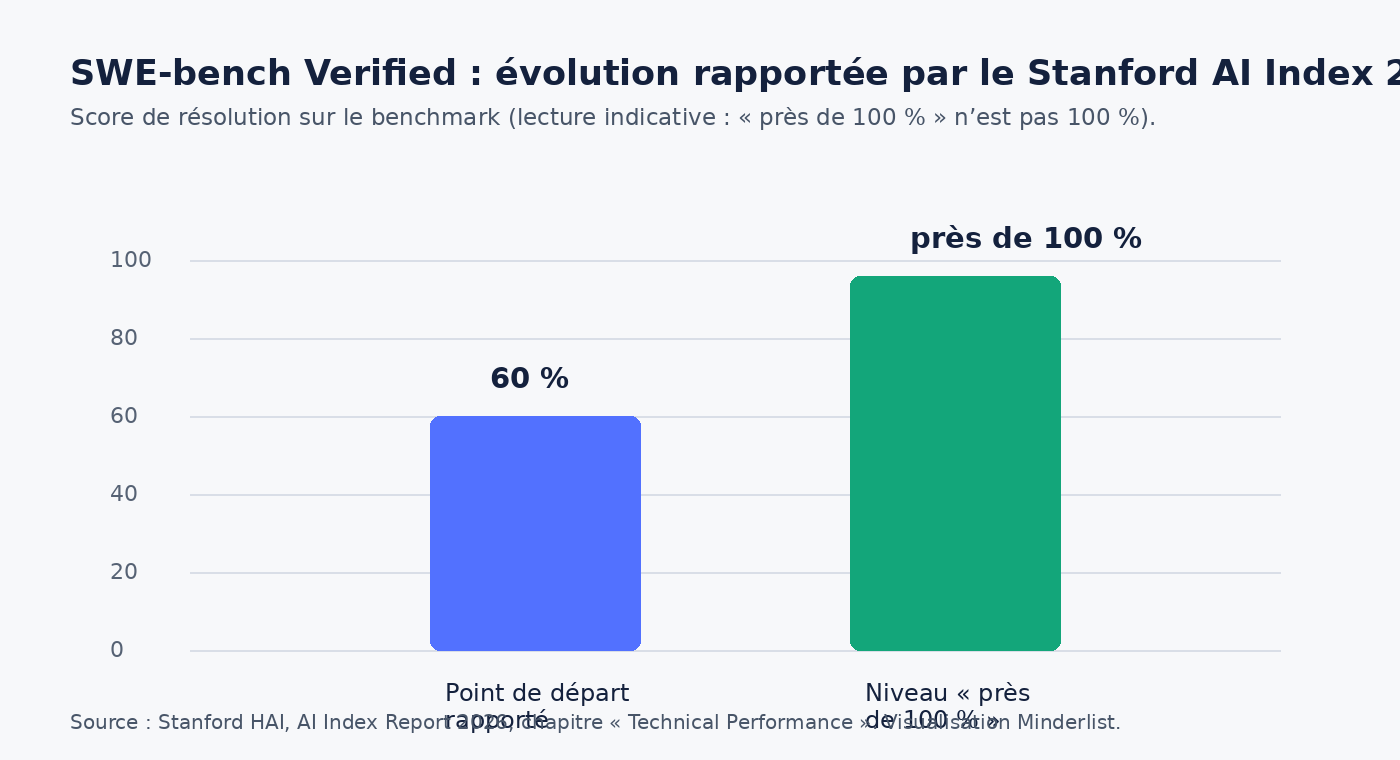
Verdict factuel : le Stanford AI Index 2026 indique qu’en un an la performance sur SWE-bench Verified est passée de 60 % à près de 100 %. C’est un saut spectaculaire sur un test de correction de bugs réels. Ce n’est pas la preuve qu’un agent peut remplacer un développeur : le benchmark encadre fortement le problème, alors que le travail logiciel comporte aussi spécification, revue, sécurité et déploiement.
Mot-clé visé : statistiques agents IA code / SWE-bench Verified 2026. La conséquence pratique est simple : un score de benchmark est devenu trop flatteur pour choisir seul un outil de code. Il faut regarder le coût de validation humaine et la capacité à travailler dans son dépôt.
Les chiffres à retenir
| Indicateur | Valeur | Périmètre | Source |
|---|---|---|---|
| SWE-bench Verified | 60 % à près de 100 % en un an | Résolution d’issues GitHub sélectionnées | Stanford HAI, 2026 |
| Modèles de pointe notables produits par l’industrie en 2025 | plus de 90 % | Modèles recensés par l’AI Index | Stanford HAI, 2026 |
| Effet observé dans l’essai METR | 19 % de temps en plus | Développeurs open source expérimentés, tâches dans leurs propres dépôts | METR, 2025 |
Pourquoi ce score compte, et ce qu’il mesure exactement
SWE-bench évalue la capacité d’un système à produire un correctif pour une issue logicielle issue de projets GitHub. La variante Verified ne reprend pas simplement toutes les issues : elle utilise un sous-ensemble dont les tests et la validation ont été contrôlés. Le résultat est donc beaucoup plus utile qu’une démo de génération de code isolée.
Le chiffre du Stanford AI Index résume une progression technique, pas une moyenne de tous les assistants disponibles. Il ne dit ni quel modèle, ni quel environnement d’agent, ni quelle configuration de calcul une équipe doit acheter pour retrouver ce niveau. Le rapport ne doit donc pas être lu comme un taux de bugs corrigés dans une entreprise.
Ce que la hausse prouve
- Les meilleurs systèmes savent désormais enchaîner lecture du dépôt, hypothèses, modifications et exécution de tests sur des tâches bien spécifiées.
- Le code est devenu un terrain de mesure où l’écart entre générations de modèles évolue vite : un benchmark publié il y a un an peut sous-estimer les outils actuels.
- Pour les équipes, l’usage le plus crédible est la réduction du temps sur une correction circonscrite, une recherche de régression ou une première proposition de patch.
Ce que la hausse ne prouve pas
Un ticket de benchmark possède une réponse testable. Dans un produit réel, la difficulté arrive souvent avant le code : comprendre un besoin ambigu, arbitrer une dette technique, respecter des contraintes de données ou décider qu’il ne faut pas modifier le service. Un agent peut aussi écrire un patch qui fait passer les tests fournis tout en introduisant une régression non couverte.
Le contrepoint le plus utile est l’étude contrôlée de METR, publiée en juillet 2025. Avec les outils alors disponibles, des développeurs open source expérimentés ont mis 19 % de temps en plus sur des tâches de leurs propres dépôts. Ce protocole ne contredit pas SWE-bench : il répond à une autre question, dans un contexte plus ouvert et avec des personnes déjà très familières de leur code.
Le piège des comparaisons de modèles
Comparer GPT, Claude, Gemini, Qwen ou un modèle local uniquement sur une ligne de classement SWE-bench est insuffisant. Un score dépend du modèle, mais aussi du harnais d’agent, des outils de recherche, du nombre de tentatives, du budget de jetons et des tests accessibles. Deux offres affichant le même modèle peuvent donc avoir un résultat, une vitesse et une facture très différents.
| Critère de décision | Pourquoi il est plus opérationnel qu’un score seul | À vérifier |
|---|---|---|
| Validation | Un patch acceptable doit être relu et testé | Diff lisible, tests lancés, journal d’actions |
| Confidentialité | Le dépôt peut contenir des secrets ou du code propriétaire | Rétention, entraînement, région, SSO et contrôle d’accès |
| Coût réel | Les boucles agentiques consomment des jetons et du temps | Plafond par tâche, usage API, durée d’exécution |
| Intégration | La valeur dépend du flux existant | IDE, Git, CI, règles de revue et permissions |
Comment exploiter ce signal sans surinterpréter les benchmarks
- Choisissez dix tickets clos. Gardez leurs contraintes, leurs tests et une définition claire de « fait ».
- Mesurez une chaîne complète. Chronométrez préparation, exécution, revue et correction du patch, pas seulement la première réponse de l’outil.
- Imposez une barrière de sécurité. Pas de fusion automatique ; scan de secrets, tests CI et relecture restent obligatoires.
- Comparez à coût égal. Limitez les tentatives et consignez les jetons ou crédits employés par tâche.
- Décidez par type de tâche. Un outil peut aider sur les tests et échouer sur une migration ou une architecture.
Où placer SWE-Lancer dans l’analyse
SWE-Lancer, présenté par OpenAI, élargit la question aux tâches d’ingénierie et de management avec une évaluation financière. C’est une source utile pour rappeler qu’un correctif de bug n’épuise pas le travail logiciel. Mais il ne faut pas mélanger ses résultats avec SWE-bench : jeux de tâches, métriques et conditions de test diffèrent. Une comparaison honnête conserve les unités de chaque étude.
Verdict : un excellent thermomètre, pas un bon de commande
Le passage de 60 % à près de 100 % sur SWE-bench Verified explique pourquoi les agents de code sont devenus difficiles à ignorer. Il justifie un essai encadré, surtout sur des corrections reproductibles. Il ne justifie pas d’en déduire une autonomie générale ni de retirer la revue humaine. La métrique qui compte pour une équipe reste le temps total jusqu’à une modification validée dans son propre dépôt.
Questions fréquentes
SWE-bench Verified mesure-t-il la productivité des développeurs ?
Non. Il mesure la réussite sur un ensemble de tâches de correction vérifiées. La productivité inclut aussi spécification, communication, revue, déploiement et maintenance.
Un score proche de 100 % signifie-t-il que les agents sont fiables en production ?
Non. Le contexte de production est plus ouvert. Il faut tester l’outil sur des tickets réels, avec des règles de sécurité et une revue humaine.
Pourquoi l’étude METR trouve-t-elle un ralentissement ?
Son protocole portait sur des développeurs expérimentés dans leurs propres projets et sur les outils disponibles au moment de l’essai. Elle mesure un contexte différent d’un benchmark de patchs.
Sources utiles
- Stanford HAI — AI Index Report 2026, Technical Performance (2026)
- Stanford HAI — AI Index Report 2026 (2026)
- SWE-bench — dépôt et méthodologie (consulté en octobre 2026)
- METR — étude contrôlée sur des développeurs expérimentés (juillet 2025)
- OpenAI — SWE-Lancer (2025)
Article préparé par Vincent Vandegans pour Minderlist. Les chiffres sont rapportés avec leur période et leur périmètre ; ils ne sont pas des prévisions de productivité.